Data Science & Machine Learning pour non-ingénieurs
Module 1 · Module 1 — Qu'est-ce que le machine learning, concrètement · Leçon 1 sur 1
Qu'est-ce que le machine learning, concrètement
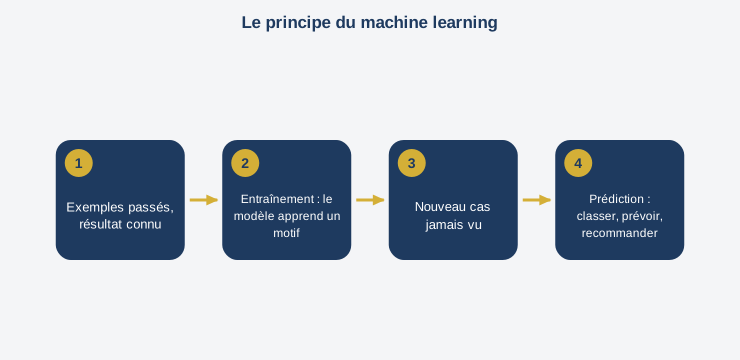
Si tu as suivi la formation Analyse de Données et Business Intelligence, tu maîtrises déjà les fondations sur lesquelles repose tout ce module : tu sais reconnaître une donnée de qualité, interroger une base avec SQL, et nettoyer un jeu de données avec Python et pandas. On ne reviendra pas sur ces bases ici — on va directement s'appuyer dessus. La vraie question de ce module est différente : qu'est-ce que le machine learning — ML, apprentissage automatique — apporte de plus qu'une analyse de données classique ? La différence tient en une phrase : l'analyse de données classique répond à des questions sur le passé — « combien avons-nous vendu le mois dernier » — tandis que le machine learning répond à des questions sur l'avenir ou sur l'inconnu — « quel client risque de partir chez un concurrent », « quel est le prix juste pour ce nouveau produit », « cette transaction est-elle probablement frauduleuse ». Le machine learning ne remplace pas l'analyse de données, il s'appuie dessus pour aller plus loin : prédire, classer, recommander. Concrètement, un modèle de machine learning apprend un motif — un « pattern » — à partir d'exemples passés, puis applique ce motif appris à de nouveaux cas jamais vus. Prenons une image simple : un modèle qui prédit si un client va se désabonner d'un service fonctionne un peu comme un vendeur expérimenté qui, après avoir vu des centaines de clients partir et rester, développe une intuition sur les signes avant-coureurs d'un départ — factures en retard, baisse d'utilisation, appels au service client. Le machine learning transforme cette intuition humaine en un calcul reproductible, appliqué systématiquement à tous les clients plutôt qu'à ceux qu'un vendeur remarque par hasard. Il faut cependant dissiper un mythe fréquent : le machine learning n'est pas une boîte magique qui devine sans données. Un modèle a besoin de nombreux exemples passés, avec leur résultat connu, pour apprendre — c'est ce qu'on appelle l'entraînement. Sans historique suffisant et pertinent, aucun modèle ne peut apprendre quoi que ce soit d'utile, quelle que soit la sophistication de l'algorithme utilisé. Prenons deux cas réels pour illustrer la différence entre un usage réussi et un usage raté du machine learning en entreprise. Cas réussi : une banque utilise un modèle de scoring de crédit, entraîné sur des milliers de dossiers passés avec leur issue connue (remboursé ou en défaut), pour prioriser l'examen humain des nouvelles demandes de prêt — le modèle ne décide pas seul, il aide un analyste humain à se concentrer sur les dossiers les plus incertains. Cas raté : une entreprise de recrutement a tenté d'utiliser un modèle pour trier automatiquement les candidatures, entraîné sur les décisions d'embauche passées de l'entreprise — le modèle a fini par reproduire des biais historiques de recrutement, écartant systématiquement certains profils, parce que ses données d'entraînement reflétaient des décisions humaines elles-mêmes biaisées. Ce deuxième cas annonce un thème central de cette formation, développé plus en détail au module 7 : un modèle de machine learning n'est jamais neutre. Il reproduit fidèlement les motifs présents dans ses données d'entraînement — y compris quand ces motifs sont des biais qu'on préférerait ne pas reproduire.
Aperçu gratuit, sans compte — la suite de ce module et les modules suivants s'ouvrent après inscription.
Convaincu·e ? Inscris-toi pour débloquer la formation complète.
Voir les tarifs